 Coenfirmation Bias
De ScienceChecker-app
Iemand schrijft dat koffie gezond is. Of dat suiker beter is voor je spieren dan soja. Er staat een bron bij, een echte studie. Dus het klopt. Toch?
Niet per se. Een bron onder een bewering zegt alleen dat er een bron onder staat. Of die studie de bewering ook echt onderbouwt, is een andere vraag. Die vraag stel ik in mijn blogs, mijn podcast en mijn workshops. Nu maak ik er een app van. Dit is het verhaal van die app: waar hij begon, wat er onderweg misging, en waar hij nu staat.
Waar het begon
Het begon niet met een app, maar met een formulier. Voor het controleren van een bewering had ik een vast schema. Welke bron is het? Welke vraag stelden de onderzoekers? Hoe zag het onderzoek eruit? Wat vonden ze? En past dat bij wat de bewering zegt?
Daarnaast is er de methode die ik in workshops leer: sciencechecken in drie stappen.
De vraag. Onderzocht de studie wel wat de bewering beweert?
De vergelijking. Is er vergeleken op een manier die bij de bewering past? In voeding gaat het niet om goed of slecht, maar om beter of slechter dan iets anders.
Het antwoord. Zegt de uitkomst van de studie wat de bewering zegt?
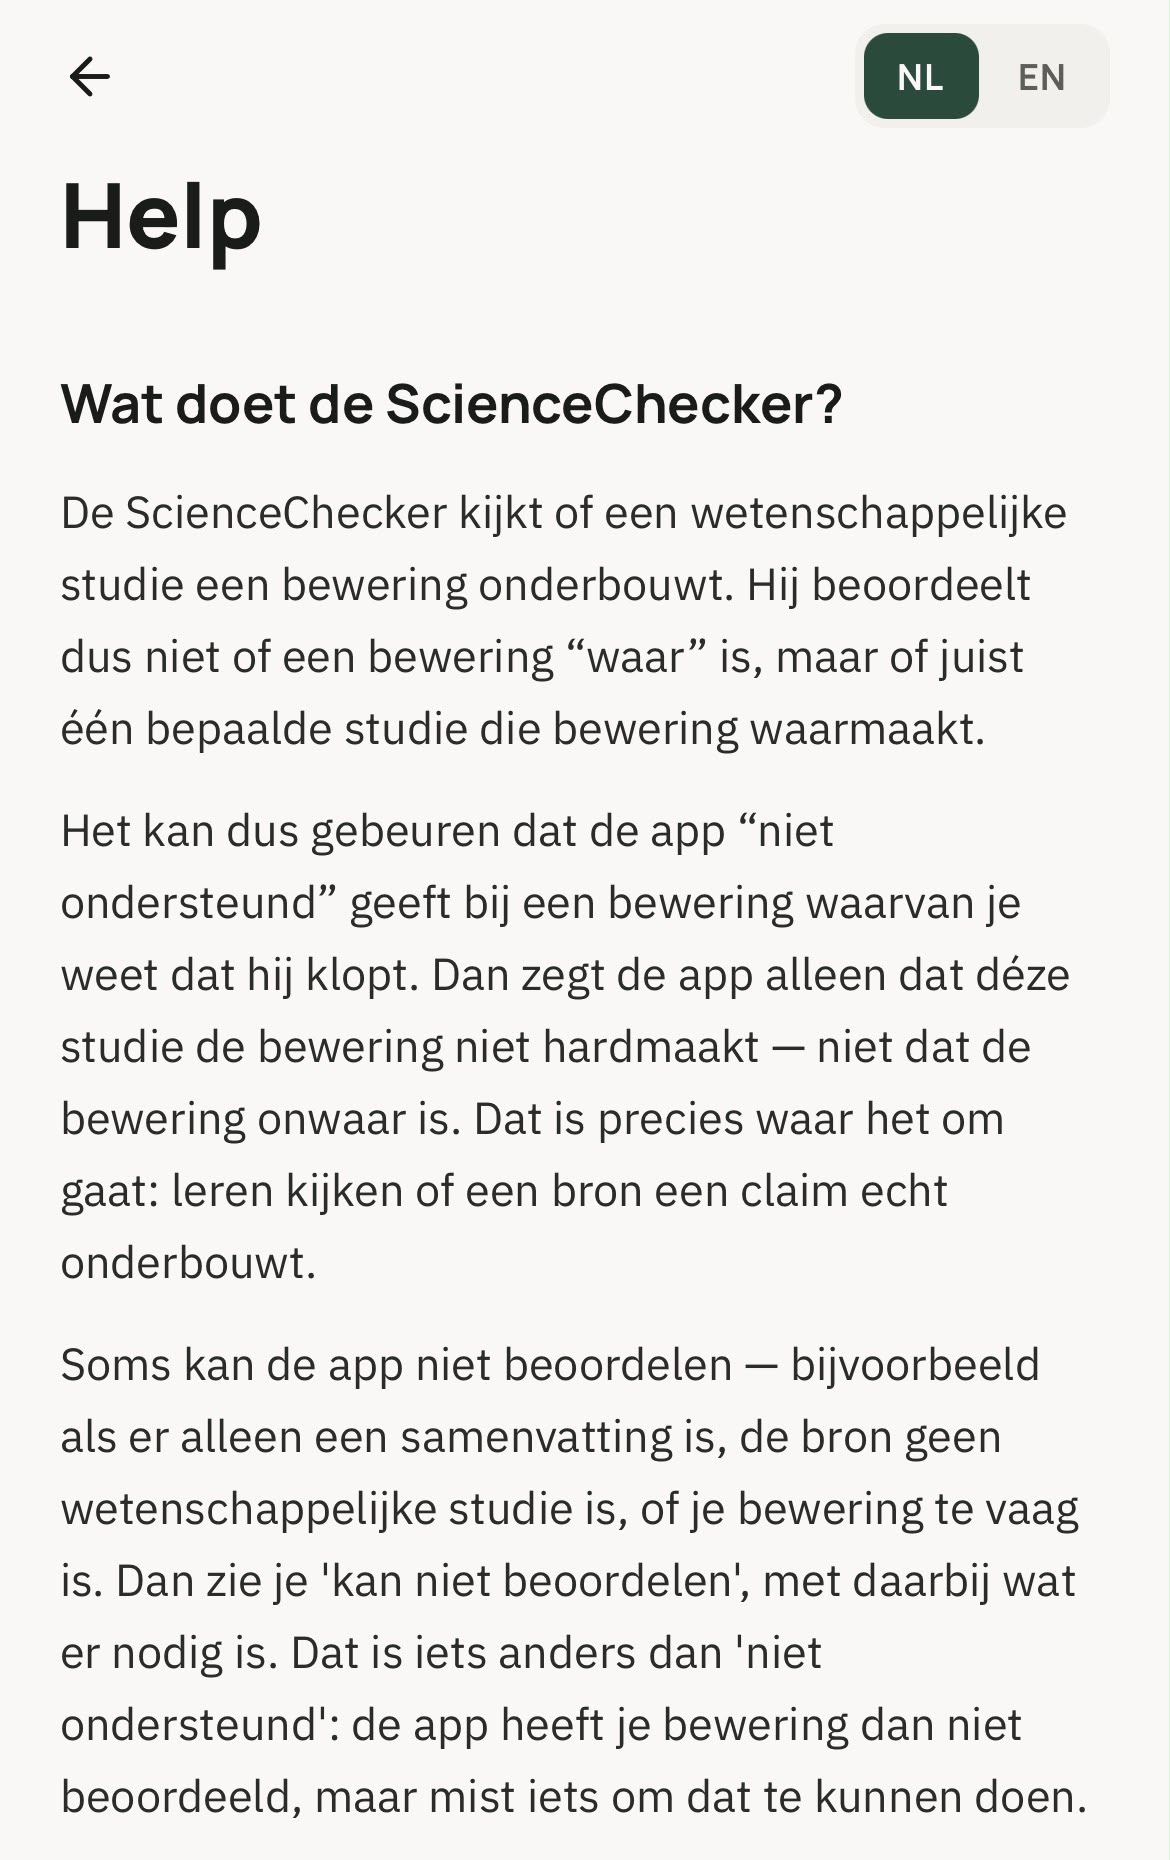
Sciencechecken is geen factchecken. De vraag is niet of een bewering waar is. De vraag is of déze bron déze bewering onderbouwt. Een bewering kan kloppen en toch slecht onderbouwd zijn. Dan zegt de app: niet ondersteund. Dat is geen fout. Dat is precies het punt.
De missie
Ik wil dat je bronnen niet zomaar gelooft, maar ze kunt nagaan. De meeste mensen slaan de bronnen over. Dat is logisch: een studie lezen kost tijd en vraagt kennis. De app moet dat makkelijker maken. Je vult een bewering in en een studie. De app doorloopt de drie stappen en laat zien waar het klopt en waar niet.
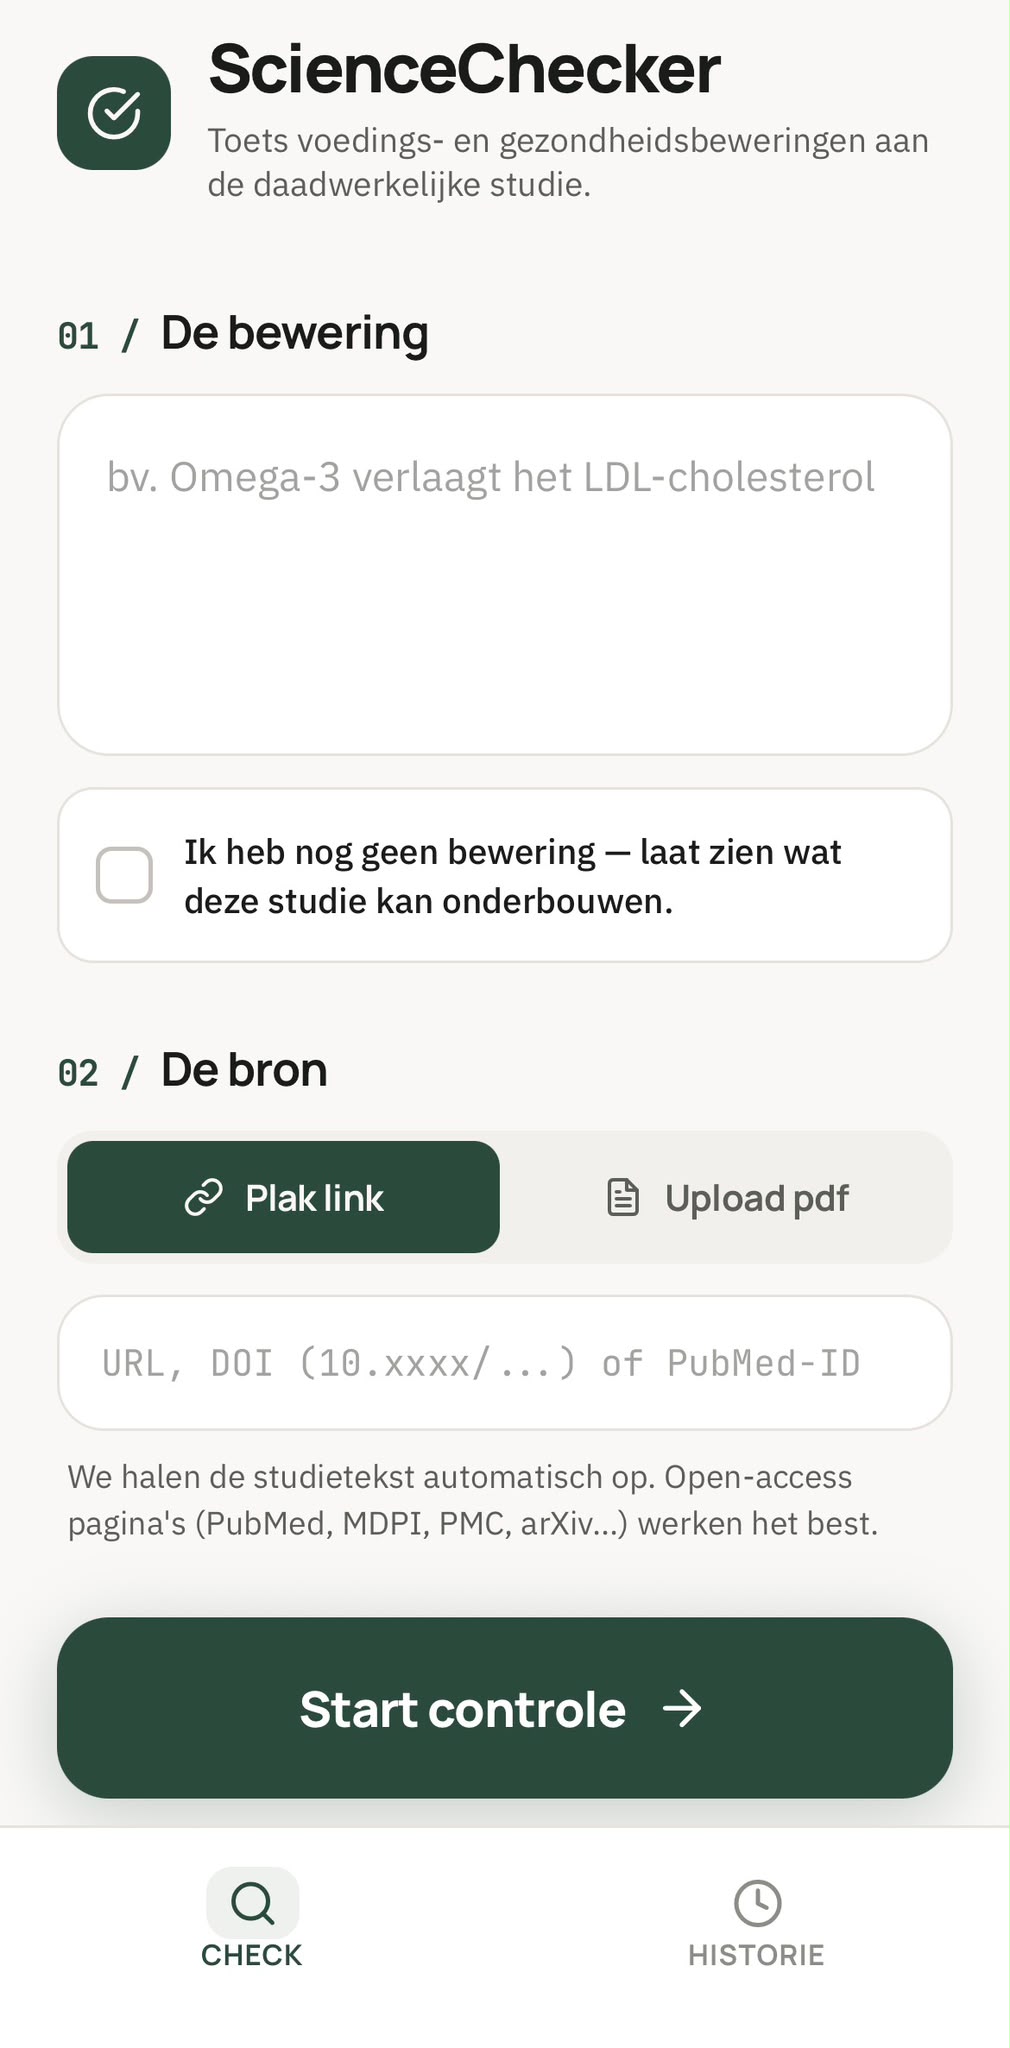
Mijn motto geldt ook hier: het gaat niet om wat de waarheid is, maar om hoe je bij de waarheid komt. De app geeft dus niet alleen een oordeel. Hij laat de redenering zien, stap voor stap, zodat je die kunt volgen en zelf kunt nakijken.
De stappen tot nu toe
Een eerste versie in een paar uur. Ik bouwde de app met Emergent. Dat is een programma waarin je in gewone taal beschrijft wat je wilt, waarna een AI de app voor je bouwt. Ik heb geen ervaring met het bouwen van apps. Toch stond er binnen een paar uur iets dat werkte: bewering erin, studie erin, oordeel eruit. Ik dacht dat het werk bijna klaar was. Het was pas begonnen.
De methode opschrijven. Als ik zelf een studie beoordeel, doe ik veel dingen zonder erbij na te denken. Een app kan dat niet. Alles moet worden opgeschreven, als regel, met voorbeelden. De methode ging daarom al snel door een reeks versies. Er gingen ook dingen uit. Het eerste plan liet de app ook het totale bewijs over een onderwerp wegen. Dat doet hij niet meer. Hij beoordeelt één bron bij één bewering, en niets anders.
De eerste testers, in juni. Een kleine groep, iets minder dan tien mensen, deed samen 35 checks. De reacties waren positief. Maar ik zag ook dat mensen zonder ervaring moeite hadden met de app. Daar maakte ik een lijst van verbeterpunten uit. Een deel daarvan zit nu in de app. Moeilijke woorden kun je aantikken voor uitleg. Er is een hulppagina. Er is een kopieerknop met een kort antwoord dat je kunt terugsturen naar wie de bewering deed. En geef je alleen een studie op, dan formuleert de app zelf de sterkste bewering die je op die studie kunt baseren. Andere punten, zoals een eigen accountpagina en een plek om vragen te stellen, wachten nog. Daarnaast werkt de app nu in het Nederlands en in het Engels.
Augustus: de eerste meting. Begin augustus waren de drie fouten opgelost die toen nog op de lijst voor de lancering stonden. Daarna ging het werk vooral over de methode zelf. Half augustus kwam de eerste meting met een vaste testset. Daarover hieronder meer.
September: bouwen en meten. In september volgde een nieuwe reeks van vijf bouwrondes. Na elke ronde wordt nagegaan of de wijziging echt in de code staat, en niet alleen in het verslag. Een tweede, losse sessie keek de laatste ronde na en vond nieuwe punten. Die staan nu op de lijst.
Waarom de methode zoveel werk is
Twee voorbeelden laten zien waarom het opschrijven van de methode zoveel tijd kost.
Iemand beweert iets over spieraanmaak. De studie heeft vetvrije massa gemeten, dus het gewicht van alles behalve vet. Is dat hetzelfde? Niet helemaal. Maar is het dan meteen fout? Ook niet. Het antwoord werd: het mag door naar de volgende stap, maar de app moet het verschil benoemen. En hij moet het verschil noemen vóór de cijfers, niet erna. Anders lees je de cijfers als antwoord op een vraag die niet gesteld is.
Of neem "Koffie is gezond". Klinkt als een bewering, maar wat is gezond? Dat kun je niet meten. De app moet hier stoppen en zeggen dat de bewering te vaag is om te toetsen. "Koffie verlaagt de bloeddruk" kan hij wel toetsen. Het verschil tussen die twee zinnen moest in een regel worden vastgelegd.
De eerste volledige versie van de methode was versie 3. Nu is het versie 6.4. Alles staat in drie documenten: één over hoe een bron wordt beoordeeld, één over de techniek en de kosten, en één over wat de gebruiker op het scherm ziet. Daarnaast is er een logboek waarin elke beslissing staat, met de reden erbij.
De grootste uitdagingen
Een taalmodel geeft niet altijd hetzelfde antwoord. Achter de app zit een taalmodel: een AI die tekst leest en schrijft. In mijn geval is dat Claude, van Anthropic. Stel je het twee keer dezelfde vraag, dan krijg je niet altijd precies hetzelfde antwoord. Bij de eerste meting was het eindoordeel binnen elk testgeval steeds hetzelfde. Maar de details eromheen wisselden: de opmerkingen bij een oordeel en de beoordeling per stap. Voor een app die over wetenschap oordeelt, moeten ook die details kloppen.
Het model volgt eerder een voorbeeld dan een regel. Dat was een verrassing. In een eerdere versie zeiden een regel en een voorbeeld niet precies hetzelfde. Ik zag die botsing acht keer terug in de antwoorden van het model. Alle acht keer koos het model de lezing van het voorbeeld, niet die van de regel. In dit geval woog het voorbeeld dus zwaarder dan de regel. Daarom moet elk voorbeeld precies kloppen met de regel erboven.
Meten in plaats van geloven. Daarom is er een vaste testset gekomen: een reeks beweringen met een bron erbij, waarvan vooraf is vastgelegd wat het juiste oordeel is. Er staan nu zestien gevallen in. Elk geval hoort meerdere keren te draaien, en de uitkomst wordt naast het verwachte oordeel gelegd. Bij de laatste meting zijn vijftien van die zestien gevallen getoetst. Daarvan kwamen er dertien goed uit op het oordeel. Dat klinkt goed, maar het zegt nog niet veel. De meeste gevallen zijn daarbij maar één keer gedraaid, en de meting was van vóór de laatste bouwronde. En dertien van de vijftien is hoe dan ook niet genoeg. De drie stappen en het eindoordeel moeten honderd procent goed zijn. Niet bijna. Honderd.
De eigen administratie. Wie zo werkt, schrijft veel op. En wat op twee plekken staat, gaat vroeg of laat verschillen. Daarom heeft elk feit één eigen plek. Kleine controleprogramma's kijken of de documenten nog bij elkaar horen en elkaar niet tegenspreken. En ik werk met een vaste set werkregels. Dat zijn er nu 39. Elke regel komt voort uit een fout die echt gemaakt is.
Hoe ik werk
Ik bouw de app niet alleen. Emergent voert de bouw uit. Claude, een AI-assistent, schrijft de bouwopdrachten, de laatste tijd ook met de code erbij, controleert het resultaat en houdt de documenten bij. Dat is dezelfde naam als het taalmodel in de app, maar een andere rol. In de app beoordeelt Claude een bron. Hier helpt Claude mij bij het bouwen. Over de methode beslis ik. Claude legt de keuze voor, met de sterkste tegenwerping erbij. Kleinere keuzes laat ik soms aan Claude over, en die kijk ik achteraf na.
Dat betekent niet dat ik de AI vertrouw. Het omgekeerde. Een tweede, losse sessie leest het werk van de eerste na. Die krijgt de bestanden zelf, geen samenvatting, en zoekt naar fouten. Dat heeft al vaak fouten opgeleverd die anders waren blijven staan. Wat ik bij studies doe, doe ik dus ook bij de AI die ik zelf gebruik. Wie iets beweert, moet het laten zien. Ook een AI. Ook ik.
Waar we nu staan
De app draait, maar hij is nog niet openbaar. De vijfde bouwronde is klaar. De meting die moet laten zien of die ronde iets heeft verbeterd, staat klaar.
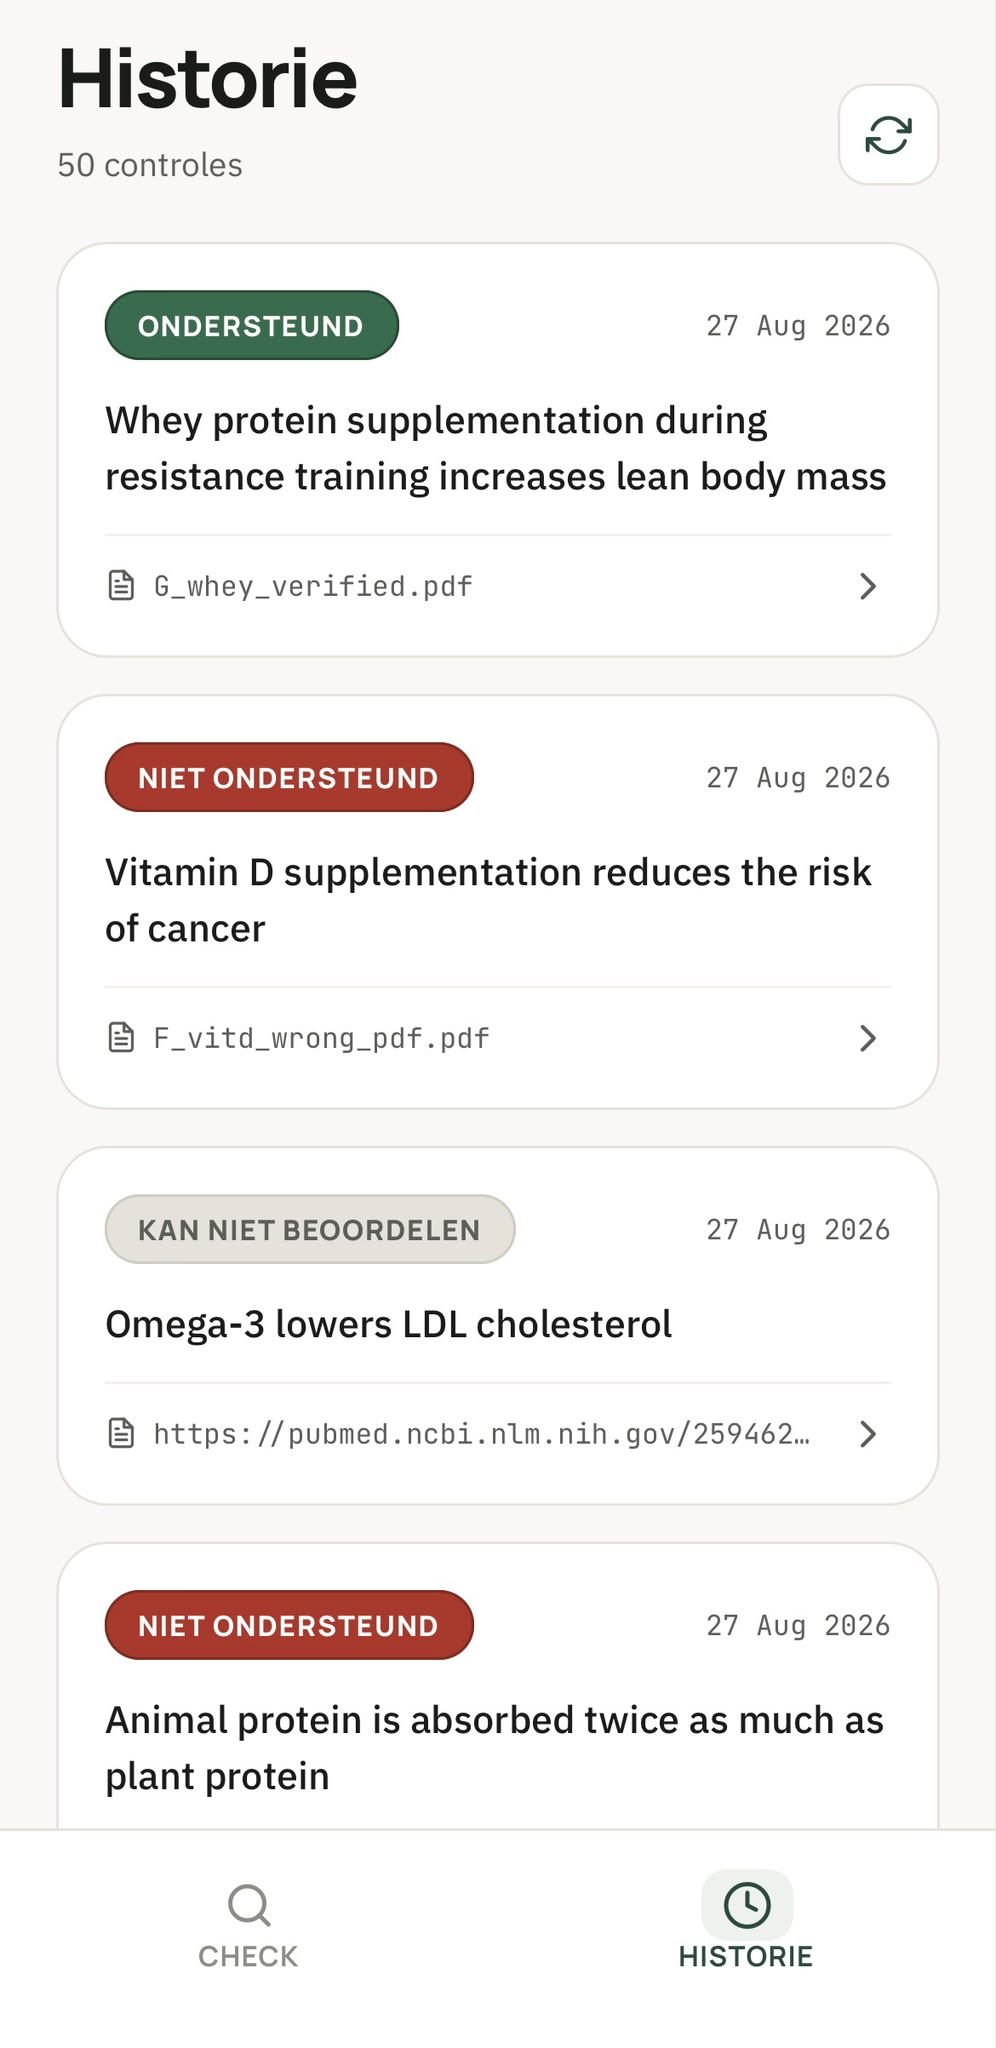
Voordat de app naar buiten kan, moet er nog het een en ander gebeuren. Onder meer beveiliging en accounts, en afspraken over kosten en gebruik. De voorwaarde die voor mij het zwaarst weegt: de testset moet laten zien dat de app de drie stappen en het eindoordeel foutloos zet. Ook dan blijft er iets over om te controleren. De testset toetst het oordeel van het model, niet alles wat de gebruiker op het scherm ziet.